Docker Swarm Monitoring Stack
로그/하드웨어 메트릭 통합 모니터링 올인원 Observability 스택
TL;DR
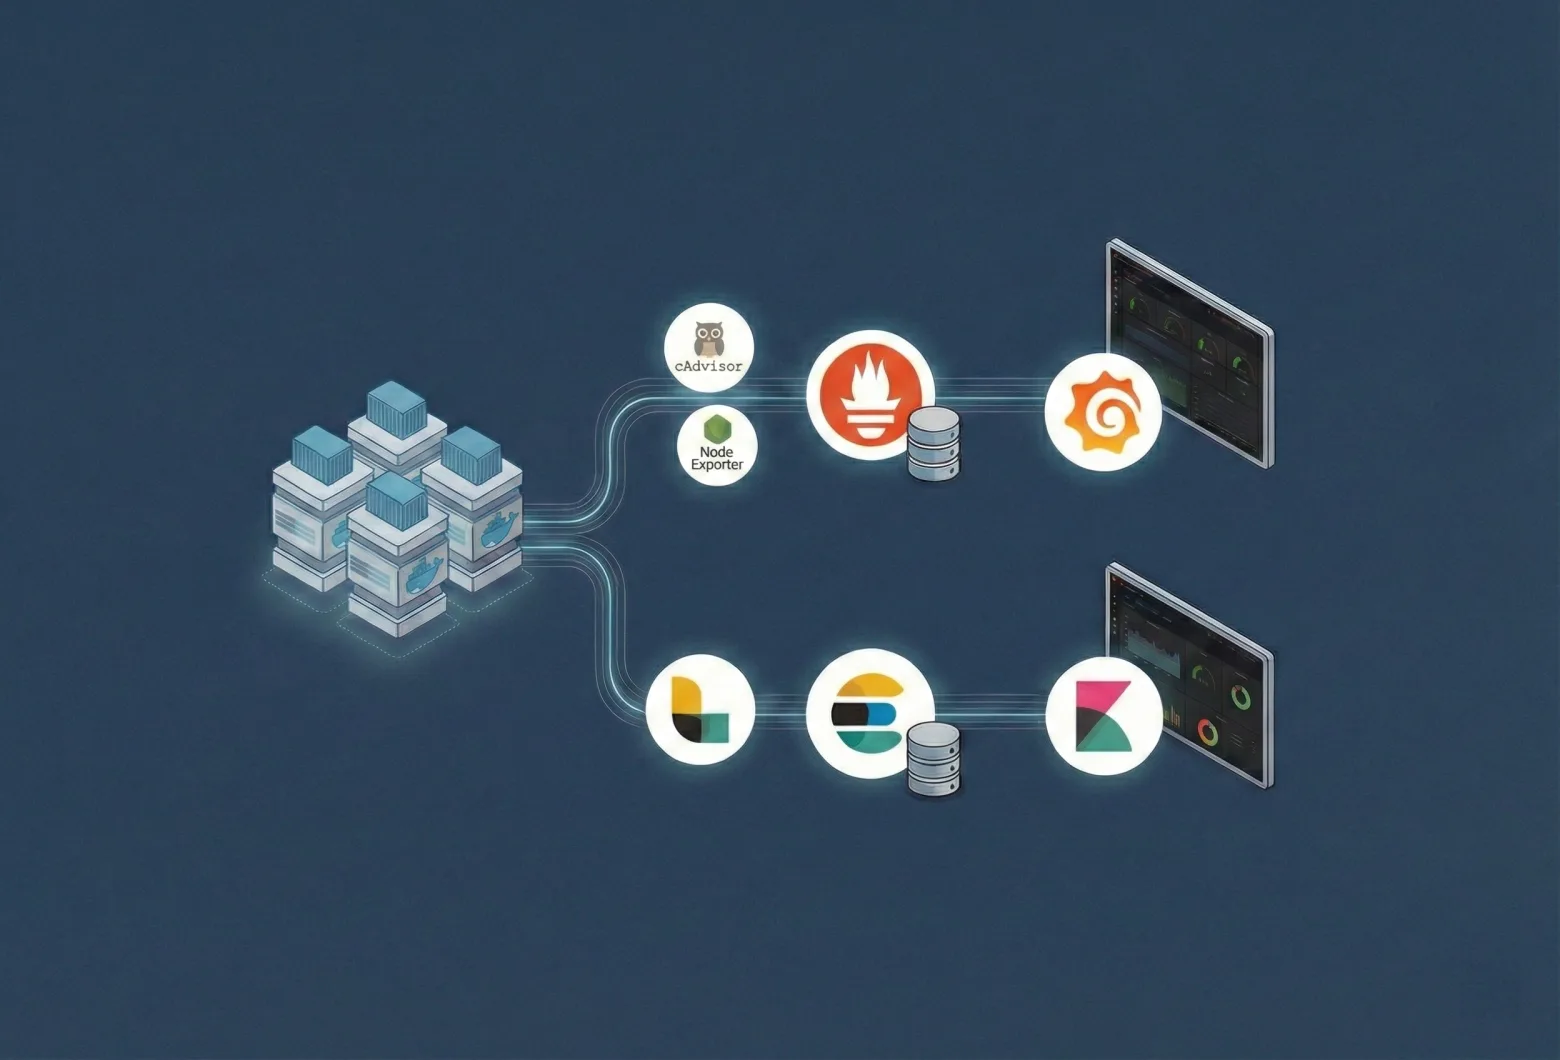
Docker Swarm위에서 동작하는 올인원 모니터링 스택입니다.ELK Stack을 사용해 로그를 수집·정제·저장·시각화하고Prometheus와Grafana를 사용해 하드웨어·컨테이너 메트릭을 수집·시각화합니다.Kubernetes도입이 어려운 환경에서Docker환경과 통합된 Self-hosting 모니터링 스택을 구축할 수 있도록 설계했습니다.- 사내 시스템 구축 경험을 바탕으로 오픈 소스 스택을 빌드해 공개했습니다.
기획
배경
이 프로젝트는 제가 사내에서 담당하던 서로 다른 성격을 가진 두 서비스의 통합 모니터링을 위해 개발한 Observability 시스템으로부터 시작되었습니다.
첫 번째 서비스는 월간 20만 건 이상의 트랜잭션 데이터를 실시간으로 처리하는 서비스로, 처리 과정에서 문제가 발생해 처리가 중단될 경우 큰 문제가 발생하는 크리티컬한 데이터들을 처리하므로 안정적인 운영을 위해 데이터 파이프라인의 건전성을 확인하고 데이터 이상이 없는지 확인할 수 있는 체계가 필요했습니다.
두 번째 서비스는 일간 100만 건 이상의 조회 트래픽이 발생하는 고부하 서비스입니다. 그렇기에 서비스의 안정성을 모니터링할 필요성이 존재했고, 동시에 트래픽을 분석해 도메인 관점의 데이터들을 뽑아내고 이를 통해 비즈니스 인사이트를 얻는 것에 대한 수요가 존재했습니다.
위와 같은 수요를 만족하기 위해 서버와 애플리케이션의 상태를 모니터링하고 도메인적 데이터를 수집할 수 있는 통합 Observability 시스템이 필요했습니다.
그러나 하기 목표 문단에서 설명하듯 시중에는 제 요구 사항들을 모두 만족시키면서 간편하게 시스템을 구축할 수 있는 도구가 존재하지 않았고, 사내 시스템을 성공적으로 구축한 경험을 토대로 직접 오픈 소스 스택을 구축해 공개하게 되었습니다.
목표
1. 도구의 파편화 해결
시중에는 훌륭한 오픈 소스 모니터링 도구들이 많았지만 그 도구들을 간편하게 통합하고 일괄적으로 관리할 수 있는 도구는 드물었습니다.
또한, 각각의 도구들을 Self-hosting 및 연결해 기존 인프라에 통합하기 위해서는 많은 인프라적 노하우와 작업량을 요구했기에 전문 지식 없이는 도입이 어려웠습니다.
2. 컨테이너 환경과 오케스트레이션 대응
도구들을 간편하게 설치하고 관리하기 위해서 Docker 컨테이너 환경 위에 구축하기로 결정했습니다. 시스템 안정성과 수평 확장의 편리성을 위해 컨테이너 오케스트레이션 기술을 추가로 도입하려고 했으나, 사내 인프라 사정상 Kubernetes를 도입하기 어려운 환경이었습니다. 그렇기에 기본 Docker 환경과 쉽게 통합되는 동시에 오케스트레이션이 가능한 대안이 필요했습니다.
3. 로그 데이터 처리 대응
시스템은 기존 애플리케이션과 빠르게 통합하는 한편 다양한 도메인 데이터를 처리해야 했는데, 이를 위해서 애플리케이션의 로그를 분석할 수 있는 시스템이 필요했습니다.
분당 몇 GB씩 쌓이는 애플리케이션 로그를 분석하기 위해서는 다량의 로그 트래픽을 안정적으로 처리할 수 있어야 하고, 로그를 올바른 형태의 데이터로 정제할 수 있어야 하며, 데이터를 빠르고 효율적으로 적재하고 조회할 수 있어야 하고, 시각화가 쉽고 간편해야 했습니다.
개발
기술 스택
1. Docker Swarm
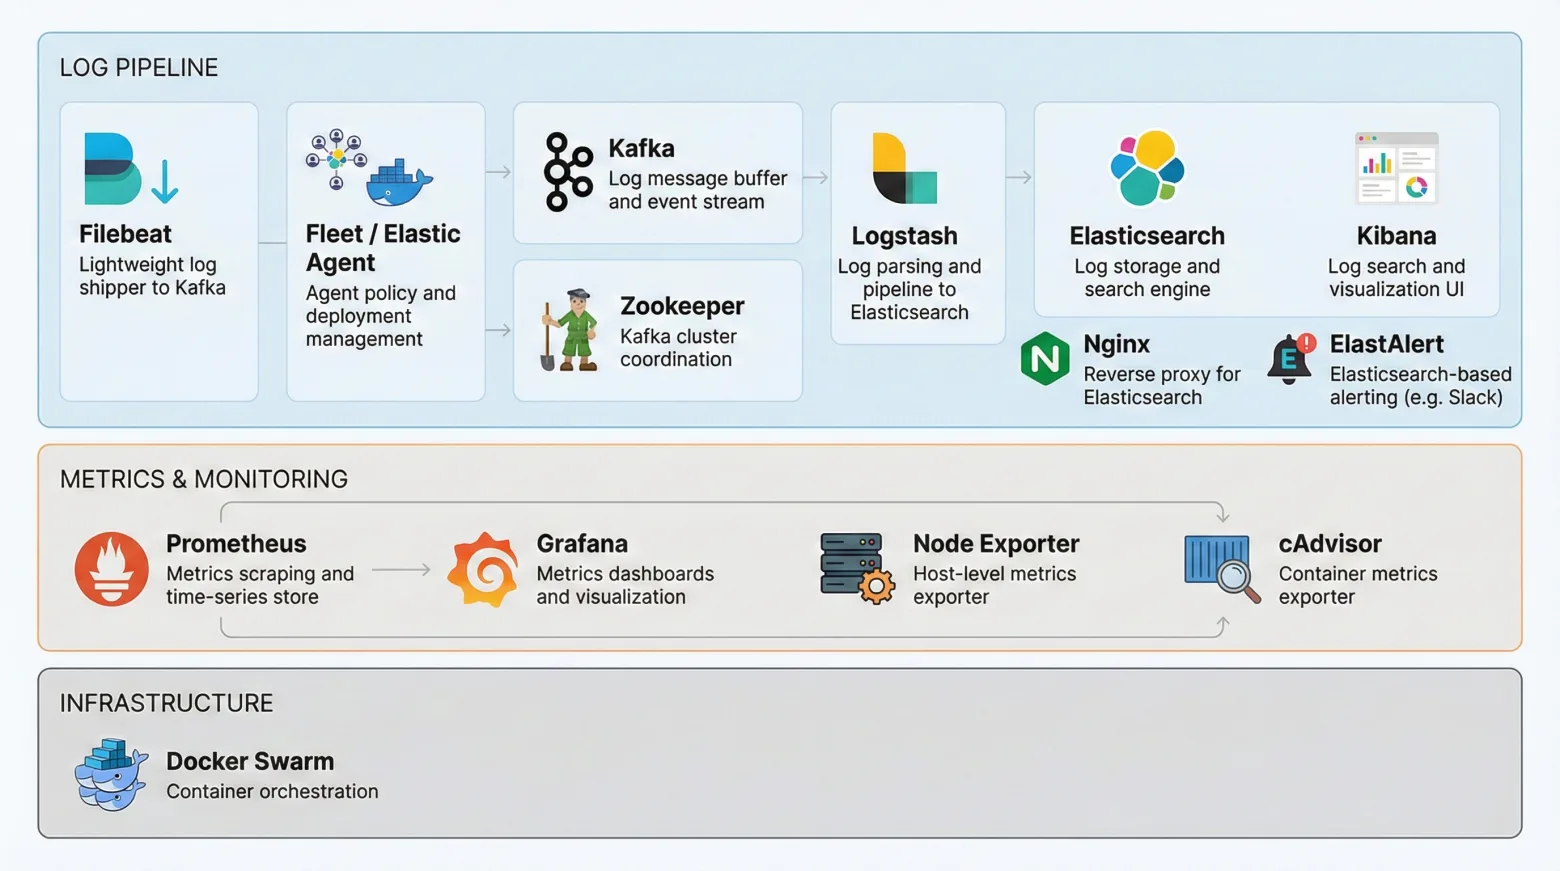
Docker Swarm은 이 모니터링 스택 전체를 구동하는 컨테이너 오케스트레이션 레이어입니다.
위에서 언급했듯 사내 인프라 사정상 Kubernetes 도입이 어려운 환경이었기 때문에, 기존 Docker 환경과 쉽게 통합되면서 오케스트레이션이 가능한 대안이 필요했습니다. Docker 엔진에 포함된 Docker Swarm은 학습 부담이 상대적으로 적었고, 자체적인 수평 확장과 서비스 배치 제어 기능만으로도 목표한 운영 안정성을 만족시킬 수 있어 이를 선택했습니다.
2. ELK Stack
ELK Stack(Elasticsearch, Logstash, Kibana, Filebeat)은 로그 데이터의 수집·정제·저장·조회·시각화까지 이어지는 파이프라인을 담당합니다.
상술했듯 간편한 구축, 대용량 로그 트래픽 처리, 로그의 정형화·정제, 빠른 적재·조회, 쉬운 시각화를 모두 만족할 수 있는 검증된 조합이 필요했고, 오픈 소스 기반 Self-hosting과 자유로운 커스터마이징이 가능하며 다른 스택과의 연동을 직접 지원하는 ELK Stack을 선택했습니다.
2.1. Nginx
Nginx는 Elasticsearch의 리버스 프록시로 동작합니다. Swarm 내에서 Elasticsearch는 노드별로 여러 인스턴스가 클러스터링된 형태로 동작하기 때문에 Swarm 외부에서 접근할 수 있는 단일 진입점이 필요합니다. 또한, 외부 진입점에 대한 접근 제어와 보안 정책을 설정해야 합니다. Nginx를 리버스 프록시로 설정함으로써 두 조건을 모두 만족시킬 수 있어 Nginx를 선택했습니다.
2.2. Elastic Agent / Fleet
Elastic Agent는 Beats 제품군을 통합한 단일 에이전트로, 대상 서버에 설치되어 메트릭(APM, 로그, 하드웨어 메트릭)을 통합 수집합니다. 중앙 정책 서버인 Fleet과 연동되어, 서버별 수집 정책을 일일이 수정할 필요 없이 Kibana를 통해 원격으로 통합 관리할 수 있습니다.
현재 ELK Stack 생태계는 Beats 제품군을 넘어 Elastic Agent + Fleet 아키텍처를 차세대 표준으로 채택하는 추세이며, 이에 발맞추어 본 프로젝트에서도 최신 아키텍처 지원을 추가했습니다.
2.3. ElastAlert
ElastAlert는 Elasticsearch 인덱스를 주기적으로 조회해 규칙(빈도, 패턴 등)에 일치하는 데이터가 있는지 검사하고, 조건이 충족되면 연결된 외부 채널로 알림을 발송합니다. 데이터 기반의 실시간 알림을 구현하는 데 사용했습니다.
Elasticsearch에도 자체 알림 기능이 존재하나, 유료 서비스를 구독해야만 이용할 수 있었습니다. 알림 기능의 오픈 소스 대안으로서 ElastAlert를 통합했습니다.
3. Kafka & Zookeeper
Kafka는 Filebeat와 Logstash 사이에서 메시지 버퍼이자 이벤트 파이프라인 역할을 합니다. 로그를 토픽 단위로 받아 두었다가 Logstash가 소비하도록 해 수집부와 적재부를 분리하고, 트래픽이 급증해도 파이프라인이 끊기지 않도록 했습니다.
Zookeeper는 분산 코디네이션 서비스로, 클러스터링된 Kafka 브로커들의 상태를 확인해 장애 발생 시 Failover를 지원합니다.
다량의 로그 데이터를 버퍼 없이 Logstash로 전송하자 서버 부하가 심해져, 중간에 버퍼 역할을 할 데이터 파이프라인이 필요했고 해결책으로 Kafka를 도입했습니다. 구체적인 배경과 해결 과정은 아래 트러블슈팅 섹션에서 설명하겠습니다.
4. Prometheus & Grafana
Prometheus는 Docker Swarm 노드 서버들에 설치한 Node Exporter, cAdvisor를 통해 하드웨어 및 컨테이너 시스템 메트릭을 수집해 저장하고,
Grafana는 저장된 메트릭을 조회해 서버와 컨테이너의 리소스 현황을 시각화해 제공합니다.
상술했듯 애플리케이션 로그와 서버 하드웨어 메트릭을 둘 다 모니터링할 필요가 있었으나,
주로 문서 단위 인덱싱을 통한 도메인적 맥락 분석에 특화된 ELK Stack에서 시계열 기반의 하드웨어 메트릭을 같이 처리하는 경우
리소스를 비효율적으로 사용하는 문제가 있었습니다. 이를 해결하기 위해 메트릭 집계에 최적화된 경량화 스택이 필요했고,
결론적으로 Prometheus와 Grafana를 사용하게 되었습니다. 구체적인 배경과 해결 과정은 아래 트러블슈팅 섹션에서 설명하겠습니다.
4.1. Node Exporter & cAdvisor
Node Exporter는 각 Swarm 노드 단위의 시스템 메트릭(CPU, 메모리, 네트워크 사용량 등)을 수집해 Prometheus로 전송합니다. Prometheus 생태계의 공식 Exporter이기에 연동의 편리성을 고려해 선택했습니다.
cAdvisor는 각 노드에서 동작하는 컨테이너 단위의 시스템 메트릭을 수집해 Prometheus로 전송합니다.
Node Exporter가 서버 전체의 메트릭을 수집하는 동시에 cAdvisor가 서비스(컨테이너)별 메트릭을 수집해 서버 단위의 스케일링 판단과 컨테이너 단위의 리소스 사용 추적 모두를 할 수 있도록 설계했습니다.
아키텍처
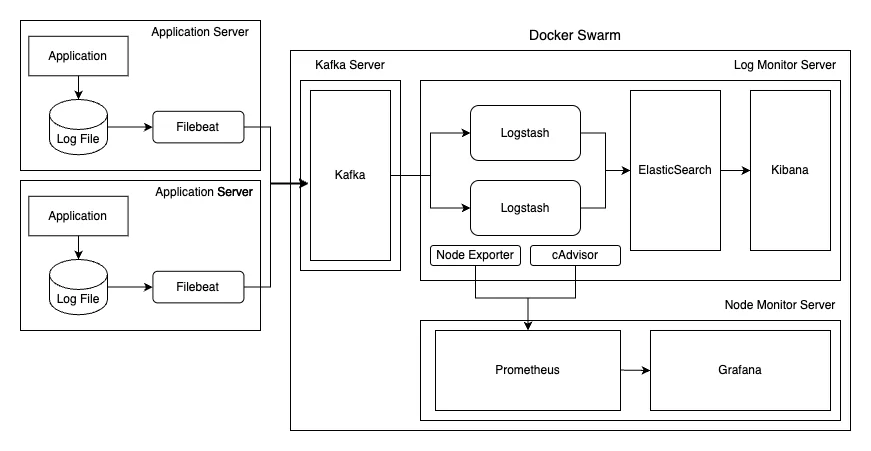
아키텍처는 애플리케이션 서버, 데이터 버퍼 서버, 로그 모니터 서버, 노드 모니터 서버로 구성됩니다.
1. 애플리케이션 서버
모니터링의 대상이 되는 애플리케이션의 인스턴스가 동작하는 서버입니다. 각 서버에는 Filebeat와 Elastic Agent가 설치됩니다.
Filebeat는 애플리케이션이 생성하는 로그 파일을 읽고, 메타 데이터를 추가해 Kafka의 지정된 Topic으로 전송합니다.
이때, Filebeat는 Kafka의 부하 상황을 보고 로그 파일을 읽는 속도를 조절해 네트워크 과부하를 방지합니다.
Elastic Agent는 Filebeat를 비롯한 Beats 시리즈를 통합한 차세대 메트릭 수집 에이전트로, 중앙 정책 서버 Fleet의 정책에 맞추어 데이터를 수집 및 전송합니다.
본 프로젝트에서는 Fleet 서버를 스택에 추가해 Elastic Agent 아키텍처로의 전환을 지원하고 있으나, 기본 로그 수집기로는 Filebeat를 사용하고 있습니다.
2. 데이터 버퍼 서버
애플리케이션 서버와 로그 모니터 서버 사이에서 처리 부하를 조절하는 데이터 버퍼 역할을 하는 서버로, Kafka와 Zookeeper가 배치됩니다.
Kafka는 Filebeat에서 전달한 로그 데이터를 수신해 Topic별 메시지로서 분류 및 저장하고, Consumer - Logstash가 데이터를 요청할 시 전달해주는 데이터 버퍼 역할을 합니다.
Zookeeper는 Kafka 클러스터의 메타데이터를 관리하고, 브로커들의 상태를 코디네이션하는 역할을 합니다.
본 프로젝트에서는 구성의 편의성을 고려해 클러스터링을 설정하지 않았으며, 차후 별도로 확장할 수 있도록 Docker Compose로 묶은 단일 Kafka와 Zookeeper를 사용하도록 구성했습니다.
3. 로그 모니터 서버
로그 데이터의 수집·정제·저장·조회·시각화를 처리하는 서버입니다. 데이터 처리를 담당하는 ELK Stack, Nginx, Fleet 등으로 구성됩니다.
ELK Stack은 Logstash, Elasticsearch, Kibana로 구성됩니다.
Logstash는 Kafka에서 로그 데이터를 가져온 뒤 정해진 형식에 맞게 가공해 Elasticsearch에 전달하는 역할을 합니다.
여러 Topic을 통해 들어오는 대량의 데이터를 처리하기 위해서는 유연한 Scale-out이 필요하므로 여러 노드를 점유하는 형태로 구성했습니다.
Elasticsearch는 로그 데이터를 문서 형식으로 저장 및 인덱싱해 데이터 소스에 제공합니다. Logstash와 마찬가지로 유연한 Scale-out 지원을 위해 클러스터링을 지원했습니다. 또한, Nginx를 리버스 프록시로 둠으로써 외부 접근에 대한 단일 진입점을 제공함과 동시에 보안을 갖출 수 있도록 했습니다.
Fleet은 앞서 이야기한 Elastic Agent의 중앙 통제 서버로 수집 정책을 일괄 관리하는 역할을 합니다. Elastic Agent 기반 아키텍처로의 마이그레이션을 지원하기 위해 추가했습니다.
Kibana는 Elasticsearch에 인덱싱되어 있는 로그 데이터를 시각화하고 UI를 통해 ELK Stack을 통합 관리할 수 있게 합니다.
4. 노드 모니터 서버
하드웨어 및 컨테이너 메트릭의 수집·저장·시각화를 담당하는 서버입니다.
각 Swarm 노드에 설치된 Node Exporter는 호스트(서버)의 시스템 메트릭을, cAdvisor는 컨테이너의 리소스 사용 메트릭을 수집해 Prometheus에게 전송합니다. 여러 컨테이너 인스턴스가 함께 동작하는 본 프로젝트의 아키텍처 상, 서버 하드웨어와 별개로 컨테이너별 리소스 사용량도 모니터링할 필요를 느꼈기에 도입하게 되었습니다.
Prometheus는 시계열 형식의 노드 모니터링 메트릭을 수집 및 저장합니다. Node Exporter, cAdvisor를 비롯한 서비스들의 엔드포인트에서 메트릭을 가져와 시계열 데이터 처리에 최적화된 방식으로 압축 및 저장합니다.
Grafana는 Prometheus에 저장된 시계열 메트릭 데이터를 대시보드 형태로 시각화해 제공합니다.
트러블 슈팅
앞서 이야기했듯, 본 프로젝트 구축에는 대용량의 로그 데이터 처리 등 여러 제약 사항이 따랐습니다. 이를 해결하는 과정에서 어떤 문제가 발생했고, 어떻게 풀어냈는지에 대한 경험을 공유하겠습니다.
1. 로그 데이터 처리 과부하
앞서 설명했듯, 처리해야 하는 로그 데이터는 분당 몇백 MB에서 많게는 GB에 달하는 큰 용량을 가진 데이터였습니다.
첫 구축 시 이러한 대용량 데이터를 별도의 데이터 버퍼 없이 Filebeat에서 Logstash로 바로 전송했는데,
Logstash의 가용량을 넘는 데이터들을 지속적으로 처리할 수 없었기에 점점 성능이 저하되었고 결국 과부하로 인해 처리가 멈춰 버리는 문제가 있었습니다.
차후 더 많은 서비스로 확장할 계획이 있었기에 단순한 서버 Scale-out보다는 처리 부하의 완급 조절이 필요하다고 생각했고, 로그 파이프라인 중간에 데이터 버퍼 역할을 해줄 레이어를 도입하기로 결정했습니다.
데이터 버퍼 선택 시, 두 가지 관점을 고려했습니다.
첫 번째는 운영 안정성이었습니다. 로그 데이터의 모든 흐름을 중간에서 제어하는 중요한 역할이기에 장애 발생 시 Failover가 가능해야 했으며, 추가 수요가 요구될 경우 언제든 Scale-out할 수 있어야 했고, 컨슈머의 부하에 맞추어 데이터를 전송할 수 있어야 했고, 기존 아키텍처와 간편하게 통합할 수 있어야 했습니다.
두 번째는 흐름 제어 기능이었습니다. 각자 다른 처리 방식과 도메인적 분류를 요구하는 데이터를 처리할 때, 모든 사용 사례에 대한 범용적인 필터링 방식보다는 분류별로 규칙을 정하고, 이에 따라 개별적으로 데이터를 생산하고 소비하는 방식이 더 확장성 있고 직관적인 방식이라고 생각했습니다. 따라서, 기준에 따라 데이터를 분류하고 생산 및 소비할 수 있는 기능이 필요했습니다.
여러 선택지들을 고려한 결과, 두 가지 관점을 모두 충족할 수 있는 Kafka를 선택했습니다.
운영 안정성 측면
| 요구 사항 | 해결 방식 |
|---|---|
| Failover | Replication 구조로 장애 시에도 데이터 유실 없이 무중단 운영 가능 |
| Scale-out | 트래픽 증가 시 브로커 및 파티션 확장을 통한 Scale-out 가능 |
| 컨슈머 부하 고려 | 컨슈머가 처리 가능한 만큼 메시지를 소비할 수 있는 Pull 모델 |
| 기존 아키텍처 통합 지원 | ELK Stack의 Kafka 연동 공식 지원 |
흐름 제어 기능 측면
| 요구 사항 | 해결 방식 |
|---|---|
| 데이터 생산 분류 | Topic 단위 Producer 데이터 수신 |
| 데이터 소비 분류 | Topic / 자체 규칙 기반 Consumer 메시지 소비 |
Kafka 도입으로 Logstash에 가해지는 부하가 가용량을 넘지 않도록 제한할 수 있었고,
도메인 규칙에 따라 Logstash를 분류하고, 사용량에 따라 확장할 수 있게 되어 처리량에 따른 유동적인 확장이 가능하도록 아키텍처를 재편할 수 있었습니다.
2. 무거운 하드웨어 메트릭 처리
앞서 설명했듯, 이 시스템은 로그 데이터와 서버(애플리케이션)의 상태(즉, 하드웨어 메트릭)라는 두 가지 종류의 데이터를 둘 다 처리할 수 있어야 했습니다.
첫 구축 시에는 Metricbeat에서 하드웨어 메트릭을 수집하는 방식으로 ELK Stack에서 하드웨어 메트릭까지 전부 담당했는데, 이럴 경우 두 가지 문제가 발생했습니다.
첫 번째는 데이터 저장 방면의 문제입니다. 다른 성격을 가진 로그와 하드웨어 메트릭 데이터가 같은 Elasticsearch 클러스터를 공유함에 따른 리소스 문제가 발생했습니다.
로그는 도메인/운영적 분류에 따라 다양한 저장 방식과 인덱싱 필요성을 갖기에 이벤트에 따른 문서 단위 처리(검색, 필터, 집계)가 필요한 데이터인 반면,
하드웨어 메트릭은 당시 상황을 나타내는 단순 시계열 숫자 데이터이고, 용량이 거대한 데 비해 데이터의 유효 기간이 길지 않기에 시계열 집계 외의 부가적인 처리가 필요하지 않습니다.
그런데, Elasticsearch 환경에서는 하드웨어 메트릭도 다른 데이터들과 동일하게 문서 방식으로 저장 및 인덱싱하기에 처리 오버헤드가 커졌고, 로그 인덱싱 처리량을 잠식하는 문제가 있었습니다.
또한, 보존 기간이 길어질수록 클러스터의 부하는 더 커졌기에 하드웨어 메트릭을 장기 저장하기 어려웠습니다.
두 번째는 데이터 시각화 방면의 문제입니다. 마찬가지로 다른 성격을 가진 데이터가 Kibana를 공유함에 따른 리소스 문제가 발생했습니다.
모든 데이터를 Kibana에서 시각화하기에 짧은 구간의 시계열 데이터를 지속적으로 출력해야 하는 하드웨어 메트릭과
도메인/운영적 필요에 의해 넓은 범위의 여러 형태를 가진 데이터를 출력해야 하는 로그 데이터의 시각화가 동일한 자원을 공유하게 되었고,
한쪽 트래픽이 많을 때 다른 쪽 대시보드 응답이 느려지는 현상이 발생했습니다.
단순한 컴퓨팅 자원 확장만으로는 이러한 근본적인 데이터 성격 차이와 워크로드 혼합 문제를 해결할 수 없었습니다. 그렇기에 기존 ELK Stack에서 하드웨어 메트릭 처리를 별도로 분리해야 했고,
시계열 데이터 처리에 최적화된 경량화 데이터베이스와 시각화 도구가 필요했습니다. 결과적으로, Prometheus와 Grafana를 선택하게 되었습니다.
데이터 저장 측면 - Prometheus
| 요구 사항 | 해결 방식 |
|---|---|
| 시계열 데이터 저장 최적화 | TSDB 기반의 시계열 최적화 쓰기 방식과 압축 알고리즘 적용으로 샘플당 평균 1.3 Byte 수준의 저장 용량 압축 |
| 인덱싱 오버헤드 제거 | Label 기반 다차원 데이터 모델 사용으로 I/O 리소스 최소화 |
| 장기 보존 부담 완화 | JSON 문서 단위가 아닌 단순 Float64 / Timestamp 수치 데이터 위주 저장으로 디스크 및 스토리지 비용 절감 |
데이터 시각화 측면 - Grafana
| 요구 사항 | 해결 방식 |
|---|---|
| 시계열 조회 성능 최적화 | 수치 연산 & 집계에 특화된 PromQL 사용으로 적은 부하로 대량의 메트릭 데이터 실시간 렌더링 |
| 동적 대시보드 구성 | 호스트나 컨테이너가 수시로 변경되는 동적 환경에서도 유연한 데이터 필터링 및 시각화 가능 |
Prometheus & Grafana의 도입을 통해 다른 성격을 가진 로그 데이터와 하드웨어 메트릭을 물리적으로 분리할 수 있었습니다.
이를 통해 ELK Stack 클러스터의 부하를 경감하고, 각 데이터의 성격에 맞는 워크플로우를 설정함으로써 저장 및 시각화 비용을 절감하는 동시에 확장성을 높일 수 있었습니다.
결과
모니터링 스택을 구축해 성공적으로 사내 시스템에 도입한 이후, 운영 경험을 토대로 범용적으로 사용할 수 있는 스택을 구축해 오픈 소스로 공개했습니다.
공개 이후, 모니터링에 필요한 다양한 사용 사례들을 지원하기 위해 Self-hosting 환경을 지원하는 오픈 소스 스택들을 지속적으로 통합하고 있습니다.
마치며
뜻깊은 첫 오픈 소스 개발 경험이었습니다. 실제 문제점을 찾아내고 해결해 공개하는 과정에서 범용적으로 적용할 수 있는 문제 해결 방식과 개발자 경험 최적화에 대해 많이 고려할 수 있었고, 오픈 소스 개발의 맥락에 대해서도 이해할 수 있는 경험이 되었습니다.
저는 앞으로도 제가 겪은 문제들의 해결 경험을 공유해 꾸준히 개발자 생태계에 기여하려고 합니다. 감사합니다.