| 쉽게 설명하는 알고리즘 시리즈 |
|---|
| 1. Z Algorithm |
| 2. Manacher’s Algorithm |
| 3. Finite-State Machine |
| 4. Gosper’s Hack Algorithm |
| 5. Glicko Rating System |
| 6. Lamport Timestamp |
이번 시간에는 Glicko 평점 시스템을 소개하겠습니다.
lichess에 새 계정을 만들고 한 판을 두면, 평점이 1500?으로 표시됩니다.
이 물음표를 ‘아직 잠정치니까 신경 쓰지 말라는 뜻’ 정도로 읽고 넘어가기 쉽습니다. 그런데 실제로는 훨씬 구체적입니다.
lichess 소스에서 이 물음표는 비교 한 줄입니다. 플레이어의 편차(deviation) 값이 110 이상이면 잠정 평점으로 취급하죠.
즉, UI를 위한 친절한 표시가 아니라 내부 숫자가 화면으로 새어 나온 것입니다. 그리고 그 숫자를 다루기 위해 만들어진 것이 Glicko 평점 시스템입니다.
이번 글에서는 Elo가 답하지 못하는 문제에서 출발해, Glicko가 그것을 어떻게 다루는지, 그리고 실제 서비스에서는 논문과 무엇이 달라지는지까지 알아보겠습니다.
Elo가 실제로 주는 것
Arpad Elo는 물리학 교수이자 체스 마스터였습니다. 그가 1960년 USCF를 위해 설계한 시스템은 한 가지 일을 아주 잘합니다. FIDE는 1970년에 이를 채택했습니다.
바로 승패의 나열을 비교 가능한 숫자 하나로 바꿔 주는 일입니다. 평점 차이로 기대 결과를 계산하고, 실제 결과와 비교하고, 그 차이만큼 양쪽을 움직입니다.
조절할 수 있는 값은 K 하나뿐입니다. 한 판이 평점을 최대 얼마나 움직일 수 있는지를 정하는 값이죠.
FIDE는 현재 신규 선수에게 K = 40, 30판 이후에는 20, 2400을 넘으면 10을 씁니다. 그런데 왜 이렇게 계단을 만들어 두었을까요?
K가 서로 무관한 두 가지 일을 동시에 하고 있기 때문입니다. 시스템이 얼마나 빨리 학습하는지, 그리고 한 판의 결과가 얼마나 중요한지.
이 둘은 같은 것이 아닙니다. 하지만 Elo에는 다이얼이 하나뿐이라 한쪽을 조절하면 다른 쪽도 같이 움직입니다.
결국 K 계단은 모델이 갖지 못한 무언가를 흉내 내기 위해 존재합니다. 신규 선수에게 큰 K가 필요한 이유는 시스템이 그를 전혀 모르기 때문이고, 2400 선수에게 작은 K가 필요한 이유는 시스템이 이미 충분히 알기 때문입니다.
두 문장 모두 확신에 대한 이야기입니다. 그리고 확신은 Elo가 어디에도 저장하지 않는 값입니다.
Elo에서 어색하게 느껴지는 것들은 전부 이 빈칸에서 나옵니다.
- 둘 다 1500인데 한 명은 5판, 한 명은 5,000판을 둔 플레이어가 동일한 상대로 취급됩니다.
- 3년간 한 판도 두지 않은 사람의 평점을, 시스템은 보증할 근거도 없이 계속 들고 있습니다.
- 잠정 평점 기간, 평점 하한선, 최소 대국 수 같은 장치는 전부 모델이 표현하지 못하는 구멍을 나중에 덧대어 막은 것입니다.
참고로 Elo는 경기력이 정규분포를 따른다고 가정했는데, 실제 데이터에는 로지스틱 분포가 더 잘 맞는 것으로 밝혀졌습니다. 오늘날 대부분의 구현은 후자를 씁니다. 모두가 ‘Elo’라고 부르는 시스템도 이미 한 번 수정된 Elo인 셈이죠.
오차 범위를 함께 들고 다니는 평점
Mark Glickman이 1993년 하버드 박사 논문에서 다듬어 90년대에 Glicko라는 이름으로 발표한 답은 단순합니다. 확신을 같이 저장하면 된다는 것입니다.
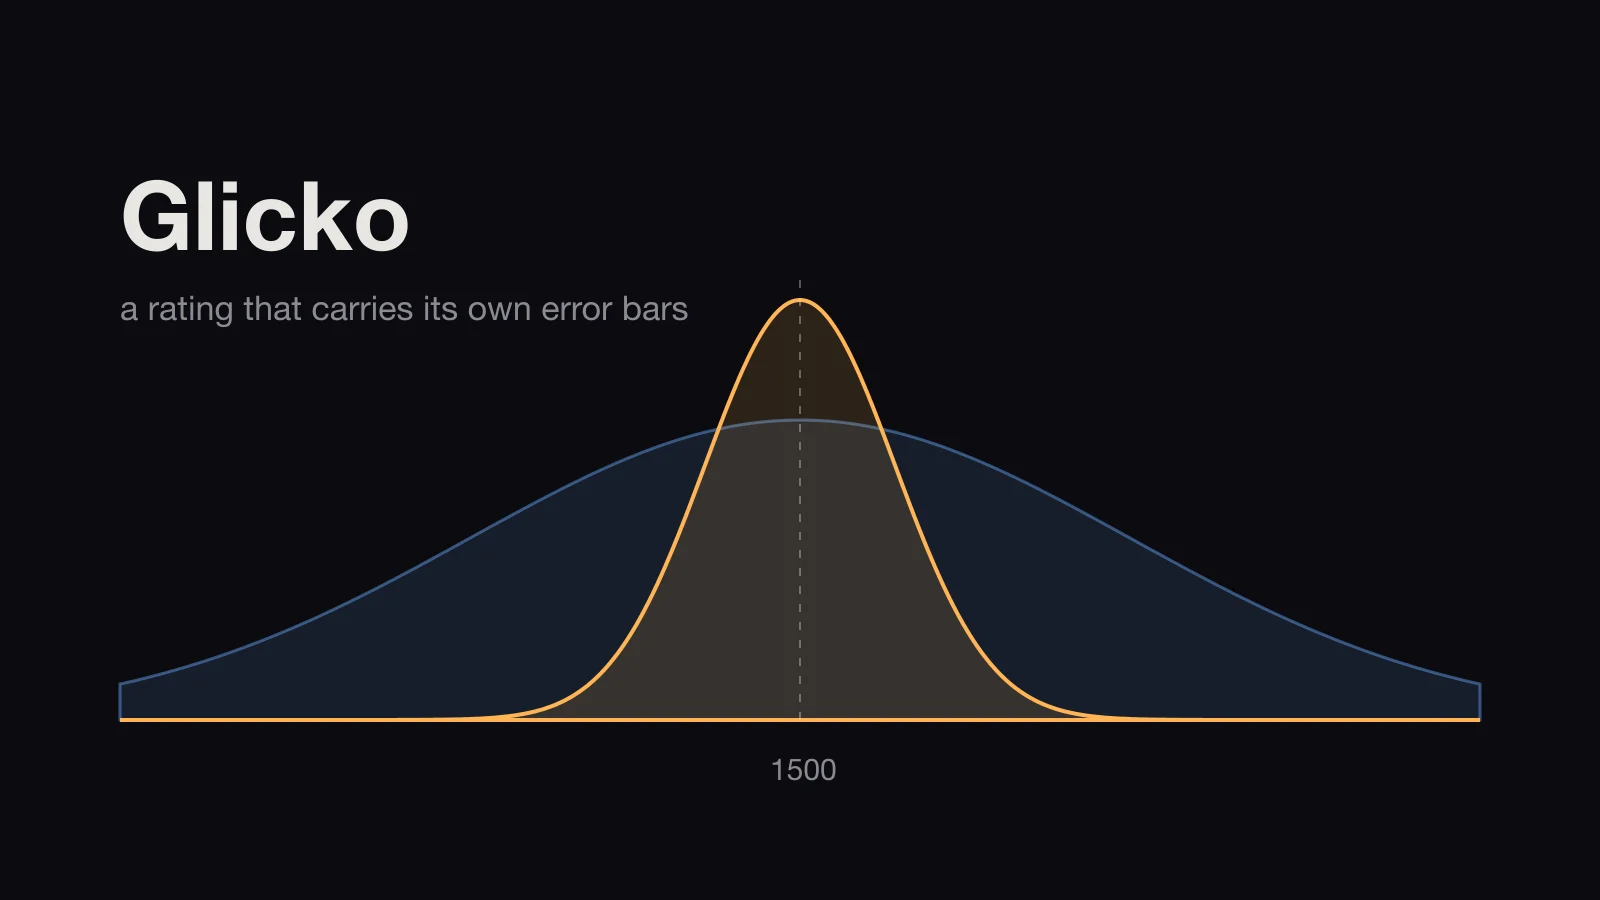
모든 플레이어는 두 번째 숫자를 갖습니다. 평점 편차, RD입니다.
RD는 평점 추정치에 대한 표준편차입니다. 따라서 평점과 RD를 묶으면 점이 아니라 구간이 됩니다.
RD가 50인 1500 플레이어는 ‘이 사람의 실력은 거의 확실히 1400에서 1600 사이’라는 주장입니다. 반면 똑같은 1500이라도 RD가 350이라면, 즉 갓 가입한 계정의 기본값이라면, 사실상 아무 주장도 하지 않은 것에 가깝습니다.
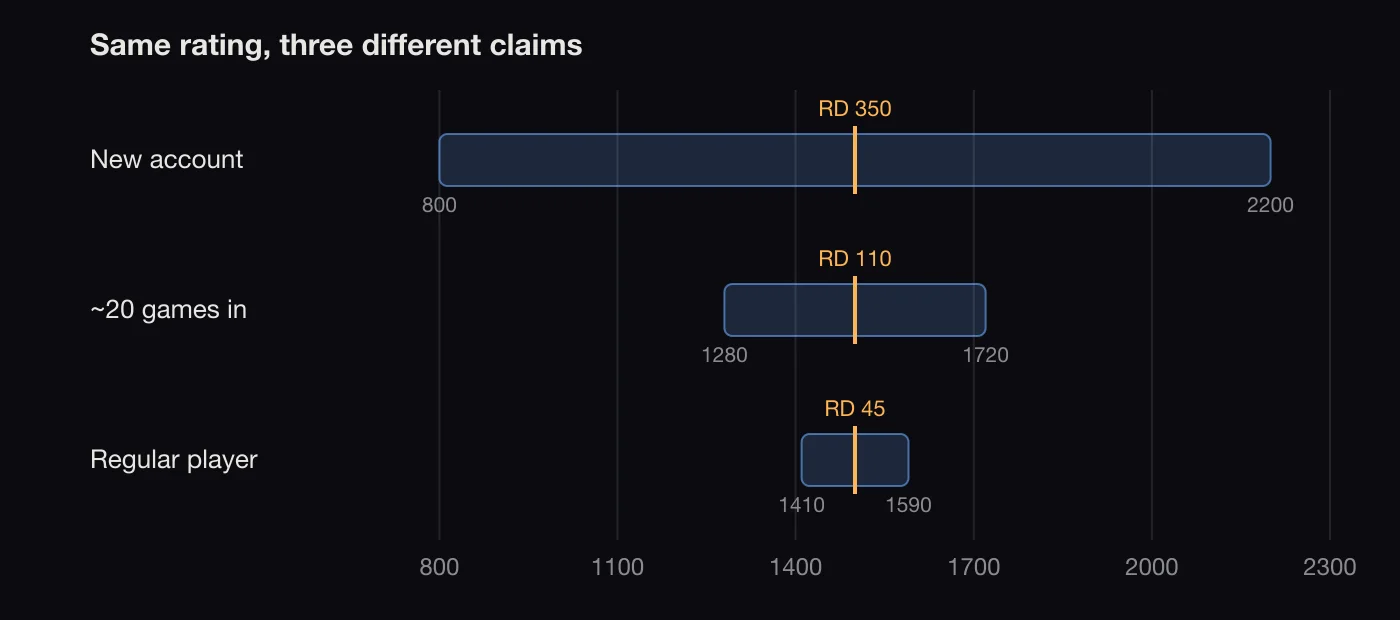 같은 평점, 세 가지 다른 주장. 구간은 대략 평점에서 RD의 두 배만큼 벌어진 범위입니다.
RD는 양방향으로 움직입니다. 경기를 하면 줄어듭니다. 결과가 곧 증거니까요.
반대로 가만히 있으면 늘어납니다. 시스템의 믿음이 ‘1년이나 지났는데 이제 누가 알겠어’ 쪽으로 서서히 흘러가기 때문입니다.
그렇다면 RD는 평점을 설명하는 부가 정보일 뿐일까요? 그렇지 않습니다. RD는 평점 갱신 자체에, 그것도 양쪽 모두에 개입합니다.
내 RD는 한 판의 결과가 나를 얼마나 움직일 수 있는지를 정합니다. RD가 크면 시스템이 내 숫자를 신뢰하지 않으니 자유롭게 움직입니다.
RD가 작으면 수백 판에 걸쳐 쌓아 올린 평점이라는 뜻입니다. 한 번의 패배로 크게 흔들려서는 안 되겠죠. 앞서 본 FIDE의 K 계단과 같은 결론인데, 선언된 것이 아니라 유도된 것이라는 점이 다릅니다.
상대의 RD는 그 결과가 얼마나 많은 정보를 담고 있는지를 정합니다. 평점 자체가 ‘글쎄요’ 수준인 사람을 이긴 결과는 시스템에 알려주는 것이 거의 없으므로, 내 평점도 거의 움직이지 않습니다.
반면 충분히 굳어진 1700을 이긴 것은 실제 정보이고, 그만큼 움직입니다. Elo에는 ‘이 결과는 저 결과보다 정보가 적다’고 말할 방법이 없었습니다.
정리하자면 평점에 확신을 붙이는 것과, 그 확신으로 증거에 가중치를 주는 것은 같은 메커니즘을 두 번 쓰는 것입니다. 그래서 시스템이 작게 유지됩니다. 원래 Glicko의 설명은 3단계짜리입니다.
모두가 어기는 가정, 평점 주기
구현이 어긋나기 시작하는 지점이 여기입니다.
Glicko는 경기를 한 판씩 처리하지 않습니다. 평점 주기(rating period) 단위로 처리합니다.
평점 주기란 수식이 동시에 일어난 것으로 취급하는 경기 묶음입니다. 모든 플레이어가 평점·RD·변동성을 들고 주기에 들어가고, 결과들이 관측되고, 주기가 끝날 때 새 값이 나옵니다.
Glickman은 Glicko-2 논문에서 이 묶음의 크기를 분명하게 못 박았습니다. 한 주기에 플레이어당 평균 10~15판 이상이 들어가는 ‘중간 이상 규모’일 때 가장 잘 동작하며, 주기의 시간 길이는 운영자가 정하라는 것입니다.
그런데 온라인 래더는 정확히 그 반대를 원합니다. 매치가 끝났는데 평점 변화를 일요일까지 기다리는 사람은 없으니까요.
그래서 거의 모든 구현이 한 판을 한 주기로 돌립니다. 논문이 경고한 바로 그 영역이죠.
이게 왜 사소한 이탈이 아닐까요? 시스템이 추정하는 대상 자체가 달라지기 때문입니다.
묶어서 처리하면 ‘이 플레이어가 이 상대군을 상대로 어땠는가’라는 하나의 질문에 한 번 답하는 것이 됩니다. 한 판씩 처리하면, 관측치 하나로 플레이어의 실력을 매번 다시 추정하는 갱신의 연쇄가 됩니다.
RD와 변동성 산출"] end subgraph P["실제 운영: 판마다"] direction TB P1["1판"] --> P2["갱신"] --> P3["2판"] --> P4["갱신"] --> P5["... 12회"] end
lichess는 중간 지점을 택했습니다. 갱신은 판이 끝날 때마다 진행된 순서대로 하되, 경과 시간 개념은 평점 주기를 소수로 쪼개어 유지합니다.
소스에 박혀 있는 상수는 하루당 0.21436 주기입니다. 왜 하필 그 숫자인지는 주석에 그대로 적혀 있습니다.
// Chosen so a typical player's RD goes from 60 -> 110 in 1 year
val ratingPeriodsPerDay = 0.21436d
앞서 본 110이 바로 잠정 평점 임계값이었죠. 즉 평범한 활동 플레이어가 손을 놓으면 정확히 1년 뒤에 물음표를 달고 돌아오도록 맞춘 숫자입니다.
논문은 감쇠 메커니즘까지만 줍니다. 평점을 언제부터 믿지 않을지는 알려주지 않습니다. 그 판단은 래더를 운영하는 쪽의 몫입니다.
이 글에서 하나만 가져가신다면 이것입니다. 평점 주기는 의도를 갖고 정하고, 왜 그렇게 정했는지 적어 두세요. 주기 길이는 학습 속도와 비활동 감쇠, 그리고 시스템을 얼마나 악용할 수 있는지를 한꺼번에 결정합니다.
Glicko-2와 변동성이라는 손잡이
Glickman이 2001년에 발표한 Glicko-2는 플레이어마다 세 번째 숫자를 추가합니다. 변동성(volatility)입니다.
RD가 ‘우리가 얼마나 확신하는가’를 묻는다면, 변동성은 ‘이 사람의 경기력이 얼마나 들쭉날쭉했는가’를 묻습니다.
이 구분이 실제로 필요할까요? 평점도 RD도 똑같은 두 플레이어를 생각해 보겠습니다.
한 명은 매주 기대치에 정확히 부합하는 결과를 냅니다. 다른 한 명은 화요일에 2000을 잡고 목요일에 1100에게 집니다.
첫 번째 플레이어의 평점은 꽤 쓸 만한 예측값입니다. 두 번째 플레이어의 평점은 결과가 계속 부정하는 숫자이고, 변동성은 시스템이 그것을 알아채는 방식입니다.
변동성이 높은 플레이어는 평점이 더 크게 출렁입니다. 계속 틀리는 평점이라면 더 빨리 움직일 수 있어야 한다는 논리죠. 신규 플레이어의 기본값은 0.06입니다.
변동성은 시스템 상수 τ로 제약됩니다. 플레이어별이 아니라 래더 전체에 한 번 정하는 값입니다.
논문이 권장하는 범위는 0.3에서 1.2 사이입니다. 다만 어느 값이 가장 좋은 예측 정확도를 내는지는 직접 테스트해서 정하라고 덧붙여 두었습니다. τ가 작을수록 변동성이 크게 흔들리지 않고, 그 결과 확률이 아주 낮은 결과 때문에 평점이 폭주하는 일을 막아 줍니다.
‘테스트해서 정하라’는 단서가 많은 일을 짊어지고 있는데, 실제로 테스트하는 곳은 거의 없습니다. τ는 대개 갖다 쓴 라이브러리 README의 예제값 그대로 굳습니다.
알아 둘 만한 구현 역사가 하나 있습니다. Glicko-2에서 반복적 근 찾기가 필요한 단계는 변동성 계산뿐인데, 초기 절차는 시작값이 나쁠 때 가끔 수렴에 실패했습니다. Glickman은 2012년 2월에 이 단계를 regula falsi의 변형인 Illinois 알고리즘 기반으로 교체했습니다. 새 절차는 반복 횟수 중앙값 5회, 10,000회 시뮬레이션 중 최대 19회였습니다. 2012년 이전에 작성된 구현을 포팅하고 있다면 Step 5가 어느 쪽인지 확인해 보시는 편이 좋습니다.
변동성 파밍
변동성에는 말로 꺼내 놓고 보면 명백한 문제가 하나 있습니다. 이것은 증폭기인데, 그 증폭기를 플레이어가 직접 조종할 수 있다는 점입니다.
이 공격은 2020년 포켓몬 GO의 배틀 리그 리더보드를 대상으로 Farming Volatility라는 글에 기록되었습니다. 절차는 아래와 같습니다.
일부러 진다"] --> B["매치메이킹이 훨씬 약한
상대를 붙여 준다"] B --> C["이기고 지는 것을
마음대로 고를 수 있다"] C --> D["승패를 번갈아 낸다:
평점은 그대로, 변동성만 상승"] D --> E["던지기를 멈추고
정직하게 전력으로 둔다"] E --> F["증폭된 상승분이 원래 자리보다
더 위로 데려다 준다"]
여기서 열쇠를 쥔 쪽은 수식이 아니라 매치메이커입니다. 충분히 떨어지고 나면 상대가 마음대로 이길 수 있는 사람들로 채워지고, 그때부터 원하는 승패 패턴을 만드는 데 드는 비용은 시간뿐입니다.
즉, 이 지점에서 하고 있는 일은 평점을 속이는 것이 아닙니다. 변동성 추정기에 직접 만든 수열을 먹이는 것입니다.
Elo-MMR 논문(Ebtekar & Liu, WWW 2021)은 이를 TopCoder 래더 시뮬레이션에서 수치로 보여 줍니다. 변동성을 파밍한 플레이어는 조건이 동일한 정직한 플레이어보다 523점 앞선 채 끝났고, 그중 1,000점 가까이가 마지막 15개 대회에서 나왔습니다.
체스판도 이 질문을 피해 가지는 못했습니다. 2021년 1월 5일에 열린 lichess 이슈 #7862의 제목은 “Glicko2 may be flawed”입니다. 내용은 정확히 이것입니다.
Glicko-2의 변동성은 플레이어가 이기려고 한다는 것을 전제합니다. 이 전제는 원래 대상이었던 공식 체스 대회에서는 성립하지만, 익명 계정과 무료 재대국과 진입 비용 없음이 결합된 래더에서는 무너집니다. Glicko-2를 도입하기 전에 ‘내 시스템에서 지는 비용이 싼가’를 먼저 확인해야 합니다.
완화책은 전부 저 순환 고리에서 다리 하나를 빼는 방식입니다.
변동성에 상한을 걸어 증폭기를 포화시키거나, 평점에 하한을 두어 일부러 떨어지는 비용을 비싸게 만들 수 있습니다. 매치메이킹 범위를 충분히 넓게 유지해 일부러 떨어진 계정도 여전히 불확실한 상대를 만나게 하는 방법도 있습니다.
마지막 방법이 ‘결과를 마음대로 고를 수 있다’는 전제 자체를 깹니다. 아니면 애초에 전략적 조작에 견디도록 설계된 시스템을 쓰는 방법도 있는데, Elo-MMR이 주장하는 쪽이 그것입니다.
실제 운영 구현은 어떻게 생겼는가
lichess의 rating 모듈을 열어 보면 논문 그대로의 Glicko-2에 어떤 논문에도 없는 안전장치가 열댓 개 둘러쳐져 있습니다.
val minRating = IntRating(400)
val maxRating = IntRating(4000)

val minDeviation              = 45
val variantRankableDeviation  = 65
val standardRankableDeviation = 75
val maxDeviation              = 500d

// past this, it might not stabilize ever again
val maxVolatility     = 0.1d
val defaultVolatility = 0.09d

// rating that can be lost or gained with a single game
val maxRatingDelta = 700

val tau = 0.75d
논문의 기본값과 나란히 놓으면 일치하는 값이 거의 없습니다.
| Glicko-2 논문 | lichess, 2024년 5월 | |
|---|---|---|
| 시작 평점 | 1500 | 1500 (매칭용 1450, 클래스 학생 800) |
| 시작 / 최대 RD | 350 | 500 |
| 최소 RD | 규정 없음 | 45 |
| 시작 변동성 | 0.06 | 0.09, 상한 0.1로 고정 |
| 시스템 상수 τ | 0.3 – 1.2, 테스트 권장 | 0.75 |
| 한 판 최대 변동폭 | 제한 없음 | 최대 700 |
| 평점 주기 | 묶음, 1인당 10~15판 | 판마다, 감쇠는 하루 0.21436주기 |
특히 maxVolatility에 달린 주석을 보면, 이 값을 넘기면 다시는 안정되지 않을 수 있다고 적혀 있습니다. 라이브 시스템이 스스로 빠져나오지 못하는 상태로 걸어 들어가는 것을 보고 그 위에 판자를 덧댄 흔적이죠. 학술지에서는 볼 수 없고, 운영에서는 반드시 필요해지는 종류의 코드입니다.
표시 규칙은 나머지 절반이고, 이쪽은 순수하게 제품 영역입니다.
| RD | 처리 |
|---|---|
| 230 이상 | "clueless" — 시스템이 이 플레이어를 사실상 모른다 |
| 110 이상 | 잠정 평점, ?를 붙여 표시 |
| 75 이하 (변형 종목은 65) | rankable — 리더보드 등재 허용 |
| 45 | 하한, 그 아래로는 내려가지 않음 |
여기서 눈여겨볼 것은 리더보드 게이트입니다. RD를 가리지 않는 랭킹은 최근 표본에서 제일 운이 좋았던 사람의 목록이 되기 쉽습니다.
TrueSkill이 평균 대신 보수적인 하한값을 노출해서 피하는 것과 같은 문제죠. RD 75 이하를 요구한다는 것은, 이 보드를 시스템이 실제로 확신하는 플레이어에게만 열어 둔다는 뜻입니다.
RD 하한도 비슷하게 중요합니다. 하한이 없으면 베테랑의 RD가 지나치게 낮아져서 시스템이 사실상 그 사람을 더 이상 갱신하지 않게 됩니다. 실력을 이미 안다고 결론 내리고 귀를 닫는 셈이죠.
RD에 바닥을 깔아 두면 시스템은 놀랄 준비를 최소한만큼은 항상 남겨 둡니다.
Glicko가 맞지 않는 지점
Glicko는 쌍대비교 모델입니다. 두 경쟁자, 하나의 결과, 그리고 반복.
내 문제가 그 모양이 아니라면, 파라미터를 아무리 조정해도 맞지 않습니다.
가장 흔한 경우가 팀전입니다. 5대5 결과는 열 명에 대한 정보 1비트이고, 그것을 개인에게 배분하는 것은 Glicko가 답하지 않는 모델링 문제입니다.
흔히 쓰는 편법은 상대 팀 평균 평점을 상대로 각자를 평가하는 것인데, 들리는 그대로의 성능을 냅니다. 집계로 보면 그럭저럭 맞고, 항의가 들어올 개별 사례마다 불공정합니다.
배틀로얄은 더 나쁩니다. 100명이 전체 순위로 끝나는 경기는 애초에 쌍대비교가 아니고, 이를 수천 개의 짝 결과로 분해하는 것은 틀린 동시에 비쌉니다.
TrueSkill은 정확히 이 문제를 위해 만들어졌습니다. Microsoft가 Halo 2 베타 데이터로 학습시켜 2005년 Xbox Live에 올린 시스템이죠.
플레이어마다 실력을 가우시안으로 모델링하고, 팀 성능을 구성원의 합으로 보며, 다자간 순위를 그대로 다룹니다. 리더보드에는 평균이 아니라 보수적인 추정치를 노출합니다. 2018년의 TrueSkill 2는 여기에 경험치, 중도 이탈 행동, 개인 스탯까지 얹었습니다.
그런데 왜 어디를 가도 보이는 쪽은 Glicko일까요? lichess, Chess.com, Pokémon Showdown, Online-Go, TETR.IO, Guild Wars 2, 스플래툰, 그리고 이름 없는 수많은 래더까지 말이죠.
이유는 두 가지인데, 둘 다 수학과 무관합니다.
첫째, 퍼블릭 도메인입니다. Glickman은 Glicko와 Glicko-2를 모두 의도적으로 퍼블릭 도메인에 두었고, TrueSkill은 특허가 걸려 있습니다. 작은 팀에게 ‘변호사 없이 쓸 수 있는가’는 예측 정확도 몇 퍼센트포인트보다 앞에 오는 질문입니다.
둘째, 하루면 구현할 수 있을 만큼 작습니다. 플레이어당 숫자 셋, 단계 몇 개, 반복 루프 하나. 운영 중에 평점이 이상해 보일 때 이유를 직접 추적할 수 있습니다.
정리하자면 1대1이고 플레이어가 정직하게 임하는 환경이라면 Glicko-2가 올바른 기본값입니다. 팀전이나 배틀로얄이라면 TrueSkill이나 OpenSkill(Weng-Lin 모델의 관대한 라이선스 구현)을 먼저 보시는 편이 낫습니다.
평점 시스템을 붙일 때 확인할 것들
지금까지 본 내용을 실제 서비스에 적용한다면, 챙겨야 할 것은 다음과 같습니다.
1. 불확실성은 저장하되, 화면에는 다른 것을 보여 준다
평점과 RD는 시스템이 추론에 쓰는 값입니다. 플레이어가 보는 것은 티어든 랭크 이름이든 보수적인 하한값이든, 나중에 마이그레이션 없이 바꿀 수 있는 무언가면 됩니다.
원시 숫자가 노출되는 순간 플레이어는 그 숫자를 향해 최적화합니다. 그때부터는 숫자를 고칠 자유가 사라집니다.
2. 리더보드는 확신을 기준으로 막는다
RD 75 이하든, 우리 시스템의 수치로 환산한 그에 준하는 기준이든 상관없습니다.
비용은 들지 않고, ‘6판 두고 보드 최상단에 있는 저 사람은 누구인가’ 부류의 문의가 통째로 사라집니다.
3. 폭주할 수 있는 값에는 전부 상한을 건다
변동성, 한 판 변동폭, 평점 하한, RD 상·하한이 대상입니다.
이 상한들은 하나하나가 모델에 오작동하는 구간이 있다는 인정입니다. 그 구간이 어디였는지를 새벽 2시에 알아내는 것보다는 전부 싸게 먹힙니다.
4. 평점 주기는 의도적으로 결정한다
한 판에 한 주기도 정당한 선택입니다. 다만 그것은 논문에 실린 것과는 다른 시스템이기도 합니다.
그 차이는 라이브러리 기본값에서 물려받는 것이 아니라 직접 고른 결과여야 합니다.
5. 누군가는 반드시 일부러 진다고 가정한다
지고 싶어 하는 플레이어가 내 시스템에서 무엇을 뽑아낼 수 있는지 확인해야 합니다.
그 답에 내가 쥐고 있는 증폭기가 등장한다면, 리더보드가 이미 망가진 다음이 아니라 출시 전에 묶어 두는 편이 낫습니다.
연습 문제
1. 논문 예제 재현하기
Glicko-2 논문에는 예제가 하나 실려 있습니다. 평점 1500에 RD 200, 변동성 0.06인 플레이어가 평점 1400(RD 30), 1550(RD 100), 1700(RD 300)과 차례로 겨뤄 첫 판은 이기고 나머지 두 판은 지는 상황이죠. 직접 구현해서 논문에 실린 최종 값과 맞는지 확인해 보세요.
2. 묶음 처리와 판당 처리 비교하기
같은 대국 기록을 한 주기에 묶어 한 번에 처리한 경우와 판마다 처리한 경우로 각각 돌려 보세요. 평점과 RD, 변동성이 얼마나 달라지는지 보면 주기 설정이 왜 중요한지 눈으로 확인할 수 있습니다.
3. 변동성 파밍 재현하기
일부러 지는 구간, 승패를 교대하는 구간, 정직하게 두는 구간 순으로 입력을 만들어 최종 평점을 계산해 보세요. 처음부터 정직하게만 둔 플레이어와 비교하고, 변동성에 상한을 걸었을 때 그 차이가 얼마나 줄어드는지도 확인해 보시면 좋습니다.
참고 자료
- Glicko rating system — Wikipedia
- Mark Glickman의 Glicko 페이지: Glicko, Glicko-2, Glicko-Boost 논문
- Glickman (1999), Parameter Estimation in Large Dynamic Paired Comparison Experiments, JRSS-C 48(3)
- The Glicko-2 system (PDF)
- lichess-org/lila — modules/rating/src/main/Glicko.scala
- lichess 이슈 #7862, “Glicko2 may be flawed”
- Ebtekar & Liu, Elo-MMR: A Rating System for Massive Multiplayer Competitions (WWW 2021)
- TrueSkill — Wikipedia
- Elo rating system — Wikipedia