| 쉽게 설명하는 알고리즘 시리즈 |
|---|
| 1. Z Algorithm |
| 2. Manacher’s Algorithm |
| 3. Finite-State Machine |
| 4. Gosper’s Hack Algorithm |
| 5. Glicko Rating System |
| 6. Lamport Timestamp |
이번 시간에는 램포트 타임스탬프(Lamport Timestamp)를 소개하겠습니다.
서로 다른 두 서버에서 올라온 로그가 있습니다.
[server-a] 12:00:00.150  주문 생성
[server-b] 12:00:00.120  주문 취소
취소가 생성보다 30밀리초 빠릅니다. 그렇다면 존재하지도 않는 주문을 취소한 걸까요?
아닐 가능성이 높습니다. 두 서버의 벽시계가 서로 조금씩 어긋나 있을 뿐이죠.
벽시계를 믿을 수 없는 이유
물리적인 시계는 저마다 다른 속도로 흐릅니다. 흔히 쓰이는 수정 진동자의 오차는 20~30ppm 정도인데, 1ppm이 하루 86밀리초에 해당하니 보정 없이 두면 하루에 2초 안팎씩 벌어지는 셈이죠.
물론 NTP로 계속 맞춰 줍니다. 오차가 작을 때는 시계가 흐르는 속도를 미세하게 바꿔 서서히 따라잡습니다(slew).
문제는 오차가 클 때입니다. ntpd는 기본적으로 128밀리초를 넘는 오차가 한동안 지속되면 시각을 한 번에 건너뛰는데(step), 시계가 앞서 있었다면 이 점프가 뒤로 일어납니다. 그러면 나중에 일어난 일이 더 이른 시각을 갖게 되죠.
시간이 뒤로 가는 상황은 생각보다 자주 문제를 일으킵니다. 2012년 윤초가 삽입되었을 때 여러 서비스의 서버가 멈춘 사건이 대표적이죠. 그래서 요즘은 시계를 되돌리는 대신 잠시 느리게 흐르게 하는 방식(leap smear)을 쓰기도 합니다.
정리하면 분산 환경에서 벽시계는 ‘대략 몇 시쯤인가’에는 쓸 수 있어도, ‘어느 쪽이 먼저인가’를 판단하는 근거로는 쓸 수 없습니다.
그렇다면 시계 없이 순서를 정할 수는 없을까요? 1978년 Leslie Lamport가 논문 Time, Clocks, and the Ordering of Events in a Distributed System에서 내놓은 답이 바로 그것입니다.
이 논문은 전산학에서 가장 많이 인용된 논문 중 하나이고, Lamport는 분산 시스템 분야의 업적으로 2013년 튜링상을 받았습니다.
먼저 일어남 관계
Lamport의 출발점은 ‘시각’이 아니라 ‘인과’입니다. 몇 시에 일어났는지는 몰라도, 무엇이 무엇의 원인이 될 수 있었는지는 알 수 있다는 것이죠.
이를 먼저 일어남(happened-before) 관계라고 하고 a → b로 씁니다. 규칙은 세 가지뿐입니다.
| 규칙 | 내용 |
|---|---|
| 같은 프로세스 | a와 b가 같은 프로세스 안에 있고 a가 먼저 실행됐다면 a → b |
| 메시지 | a가 메시지를 보내는 사건이고 b가 그 메시지를 받는 사건이면 a → b |
| 추이성 | a → b이고 b → c이면 a → c |
여기서 중요한 것은 이 관계가 전순서가 아니라 부분순서라는 점입니다.
서로 메시지를 주고받은 적이 없는 두 사건은 어느 쪽이 먼저인지 정할 수 없습니다. 이런 두 사건을 동시(concurrent)라고 부릅니다.
동시라는 말이 ‘같은 시각에 일어났다’는 뜻이 아니라는 점에 주의해야 합니다. 서로에게 영향을 줄 수 없었다는 뜻이죠. 한 시간 차이로 일어난 두 사건도 서로 모른다면 동시입니다.
알고리즘
이제 이 관계에 숫자를 붙여 보겠습니다. 각 프로세스는 카운터를 하나씩 들고 있고, 규칙은 세 줄입니다.
- 내부 사건이 일어나면 카운터를 1 증가시킨다.
- 메시지를 보낼 때는 카운터를 1 증가시킨 뒤, 그 값을 메시지에 실어 보낸다.
- 메시지를 받으면 내 카운터와 받은 값 중 큰 쪽을 고른 다음, 거기에 1을 더한다.
세 번째 규칙이 핵심입니다. 받은 값보다 반드시 커지므로, 보낸 사건이 받은 사건보다 작은 값을 갖는 것이 보장되죠.
예제
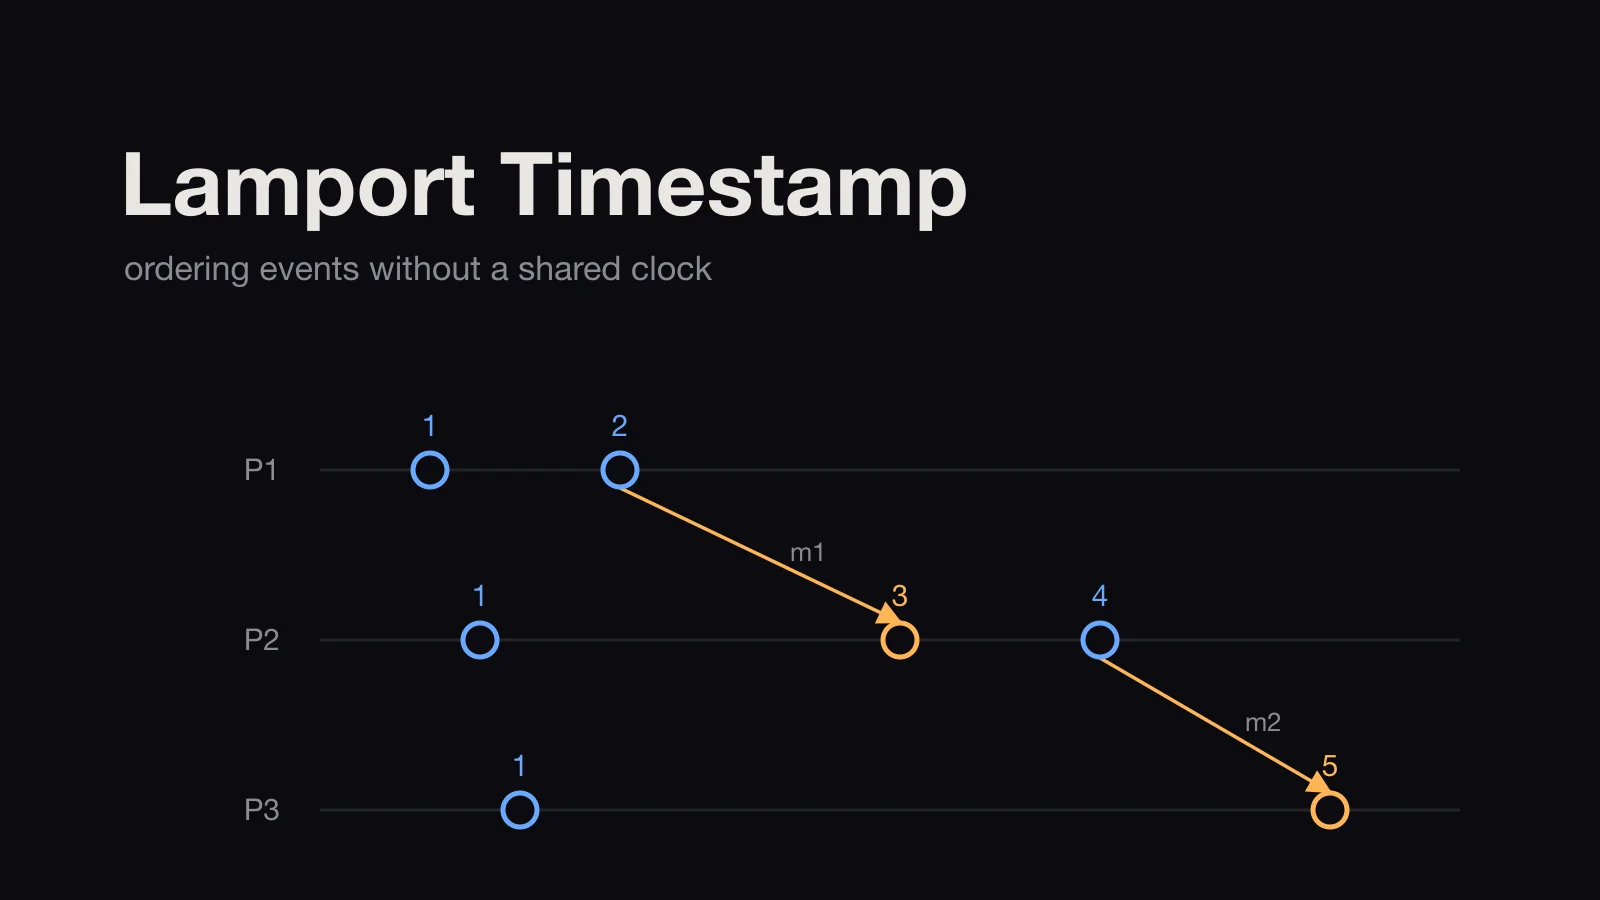
프로세스 세 개가 메시지를 주고받는 상황을 따라가 보겠습니다.
P3의 카운터가 1에서 갑자기 5로 뛰는 부분을 눈여겨봐 주세요.
P3는 그동안 사건을 하나밖에 겪지 않았지만, P1에서 시작해 P2를 거쳐 온 사건들의 영향을 받았습니다. 그 사슬의 길이가 숫자에 반영된 것이죠.
즉 이 숫자는 시각이 아니라 인과 사슬에서의 위치입니다.
구현
규칙이 세 줄이니 코드도 짧습니다.
class LamportClock:
    def __init__(self) -> None:
        self.counter = 0

    def local_event(self) -> int:
        self.counter += 1
        return self.counter

    def send(self) -> int:
        self.counter += 1
        return self.counter          # 메시지에 실어 보낼 타임스탬프

    def receive(self, received: int) -> int:
        self.counter = max(self.counter, received) + 1
        return self.counter
상태가 정수 하나뿐이고, 프로세스끼리 합의할 것도 없습니다. 분산 시스템의 알고리즘치고는 놀랄 만큼 저렴하죠.
보장하는 것과 보장하지 않는 것
여기서 많이들 오해하는 부분이 나옵니다.
램포트 타임스탬프가 보장하는 것은 한 방향뿐입니다.
| 명제 | 성립 여부 |
|---|---|
a → b이면 C(a) < C(b) | 항상 참 |
C(a) < C(b)이면 a → b | 거짓 |
C(a) ≥ C(b)이면 a → b가 아니다 | 참 (첫 명제의 대우) |
왜 두 번째가 성립하지 않을까요? 앞의 예제에서 P2의 첫 사건과 P3의 첫 사건은 둘 다 값이 1입니다.
값이 같으니 그렇다 치고, P1의 두 번째 사건(2)과 P3의 첫 사건(1)은 어떨까요? 숫자로는 P3 쪽이 작지만, 두 사건은 서로 아무 관계가 없는 동시 사건입니다.
즉 작은 숫자를 봤을 때 알 수 있는 것은 ‘먼저 일어났을 수도 있고, 아무 상관 없을 수도 있다’뿐입니다.
램포트 타임스탬프로는 두 사건이 동시인지 아닌지를 판별할 수 없습니다. 인과 관계가 있으면 순서가 보장되지만, 순서가 보인다고 인과 관계가 있는 것은 아니기 때문입니다. 이 구분을 놓치면 실제로는 충돌인 두 갱신을 순서대로 일어난 것으로 착각하게 됩니다.
전순서 만들기
부분순서만으로는 곤란한 경우가 있습니다. 줄을 세워야 하는 상황, 예를 들어 여러 노드가 하나의 자원을 두고 다툴 때가 그렇죠.
해법은 단순합니다. 타임스탬프가 같으면 프로세스 ID처럼 미리 정해 둔 순서로 승부를 가르는 것입니다.
def order_key(timestamp: int, process_id: str) -> tuple[int, str]:
    return (timestamp, process_id)
이렇게 만든 순서는 모든 노드에서 동일하게 계산됩니다. 같은 사건 집합을 보면 누가 계산하든 같은 줄이 나오죠.
원래 논문도 이 전순서를 이용해 분산 상호 배제 알고리즘을 만들어 보입니다. 중앙 조정자 없이, 모든 노드가 같은 규칙으로 같은 결론에 도달하는 방식입니다.
다만 이 순서는 합의된 순서일 뿐 진짜 순서는 아닙니다. 동시 사건에 억지로 매긴 줄이므로, 실제로 먼저 일어난 쪽이 뒤로 갈 수도 있습니다.
벡터 클락
그렇다면 동시성까지 알아내려면 어떻게 해야 할까요?
숫자 하나로는 부족합니다. 카운터를 프로세스 수만큼 들고 다니면 됩니다. 이것이 1988년 Colin Fidge와 Friedemann Mattern이 각각 정리한 벡터 클락(vector clock)입니다.
규칙은 램포트 쪽과 거의 같습니다.
- 내부 사건이 일어나면 내 자리의 값을 1 증가시킨다.
- 메시지를 보낼 때는 내 자리를 증가시킨 뒤 벡터 전체를 실어 보낸다.
- 메시지를 받으면 자리마다 큰 쪽을 고르고, 마지막에 내 자리를 1 증가시킨다.
def receive(mine: list[int], received: list[int], me: int) -> list[int]:
    merged = [max(a, b) for a, b in zip(mine, received)]
    merged[me] += 1
    return merged
비교 규칙도 간단합니다. 모든 자리가 작거나 같고 그중 하나라도 진짜 작으면 먼저 일어난 것이고, 어느 쪽도 그렇지 않으면 동시입니다.
| 벡터 비교 | 의미 |
|---|---|
[1,0,0] vs [2,1,0] | 왼쪽이 먼저 일어남 |
[2,1,0] vs [0,0,3] | 동시 (서로 영향 없음) |
[1,2,0] vs [1,2,0] | 같은 사건 |
동시성을 판별할 수 있게 된 대가는 공간입니다. 프로세스가 N개면 벡터도 N칸이고, 모든 메시지가 그 벡터를 달고 다녀야 하죠.
노드가 수시로 들어오고 나가는 환경에서는 이 비용이 꽤 부담스럽습니다.
| 램포트 타임스탬프 | 벡터 클락 | |
|---|---|---|
| 크기 | 정수 1개 | 정수 N개 |
| 인과 순서 보존 | 보장 | 보장 |
| 동시성 판별 | 불가 | 가능 |
| 전순서 | ID로 보조하면 가능 | 부분순서 |
어디에 쓰이고 있나
논리 시계는 교과서 밖에서도 계속 쓰이고 있습니다.
- 분산 데이터베이스의 충돌 감지: Riak, Voldemort, Dynamo 계열은 벡터 클락으로 같은 키에 대한 갱신이 충돌인지 순차적인지를 구분합니다.
- 인과적 일관성: 댓글이 원글보다 먼저 보이는 일을 막으려면 인과 순서를 지켜야 하고, 그 기준으로 논리 시계가 쓰입니다.
- 분산 상호 배제와 스냅샷: 원 논문의 응용이 그대로 남아 있는 영역입니다.
- 하이브리드 논리 시계(HLC): 물리 시각과 논리 카운터를 한 값에 담아, 사람이 읽을 수 있으면서 인과 순서도 지키는 절충안입니다. CockroachDB와 MongoDB가 이 방식을 씁니다.
- 버전 관리: Git의 커밋 그래프도 결국 먼저 일어남 관계를 기록한 부분순서 구조입니다.
로그에 벽시계 시각만 남기고 있다면, 요청 단위의 논리 카운터나 인과 ID를 함께 남기는 것만으로 디버깅이 훨씬 수월해집니다. 서버 간 시각이 어긋나도 순서를 복원할 수 있기 때문이죠.
연습 문제
1. 메시지 로그로 타임스탬프 복원하기
프로세스 3개가 주고받은 메시지 기록이 주어졌을 때 각 사건의 램포트 타임스탬프를 계산해 보세요. 위의 LamportClock을 그대로 쓰면 됩니다.
2. 동시 사건 찾아내기
같은 로그에 벡터 클락을 적용하고, 서로 동시인 사건 쌍을 전부 출력해 보세요. 1번의 결과와 비교하면 램포트 타임스탬프가 무엇을 놓치는지 눈으로 확인할 수 있습니다.
3. 전순서 검증하기
(타임스탬프, 프로세스 ID)로 정렬한 결과가 노드마다 동일한지 확인해 보세요. 사건을 받는 순서를 섞어도 결과가 같아야 합니다.